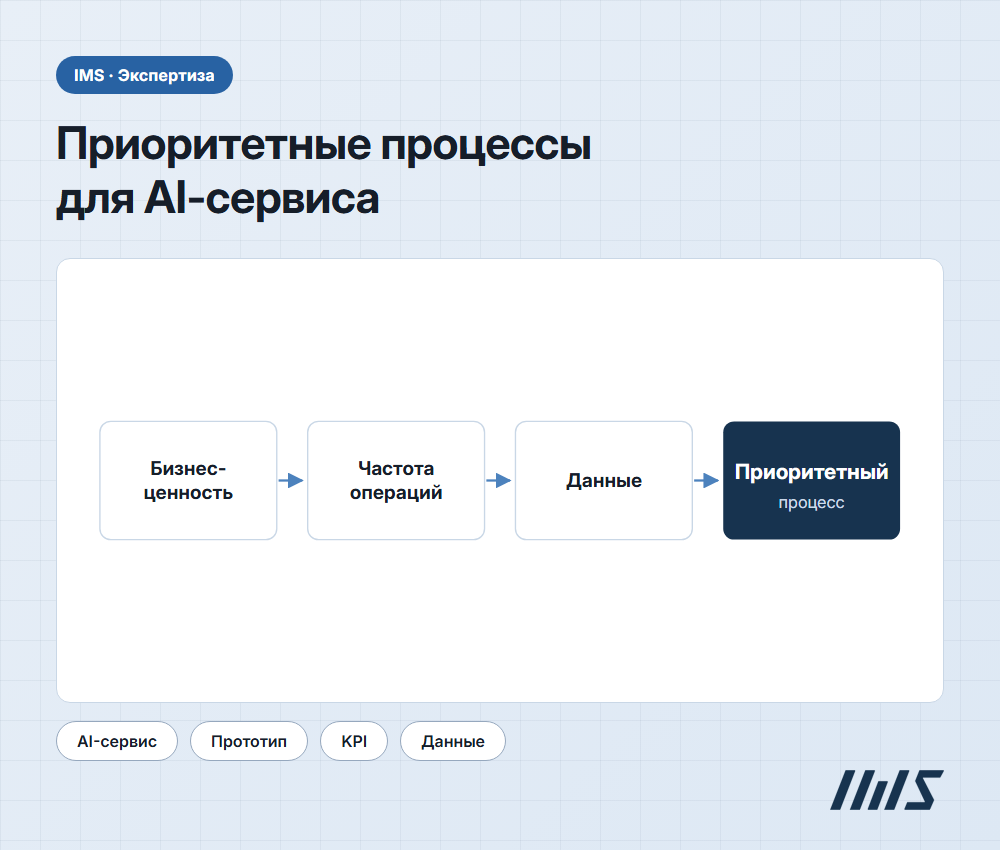
Первым для разработки AI-сервиса стоит выбирать процесс с измеримой бизнес-ценностью, регулярным потоком операций, доступными корпоративными данными и управляемой стоимостью ошибки. Технология здесь скорее вторична.. AI-сервис — это сервис на базе ИИ, который выполняет или поддерживает конкретную операцию внутри бизнес-процесса. Для первого запуска подходит то, что можно проверить на одном сценарии за 2—4 недели и затем безопасно расширить.
Как определить приоритетный процесс для AI-сервиса
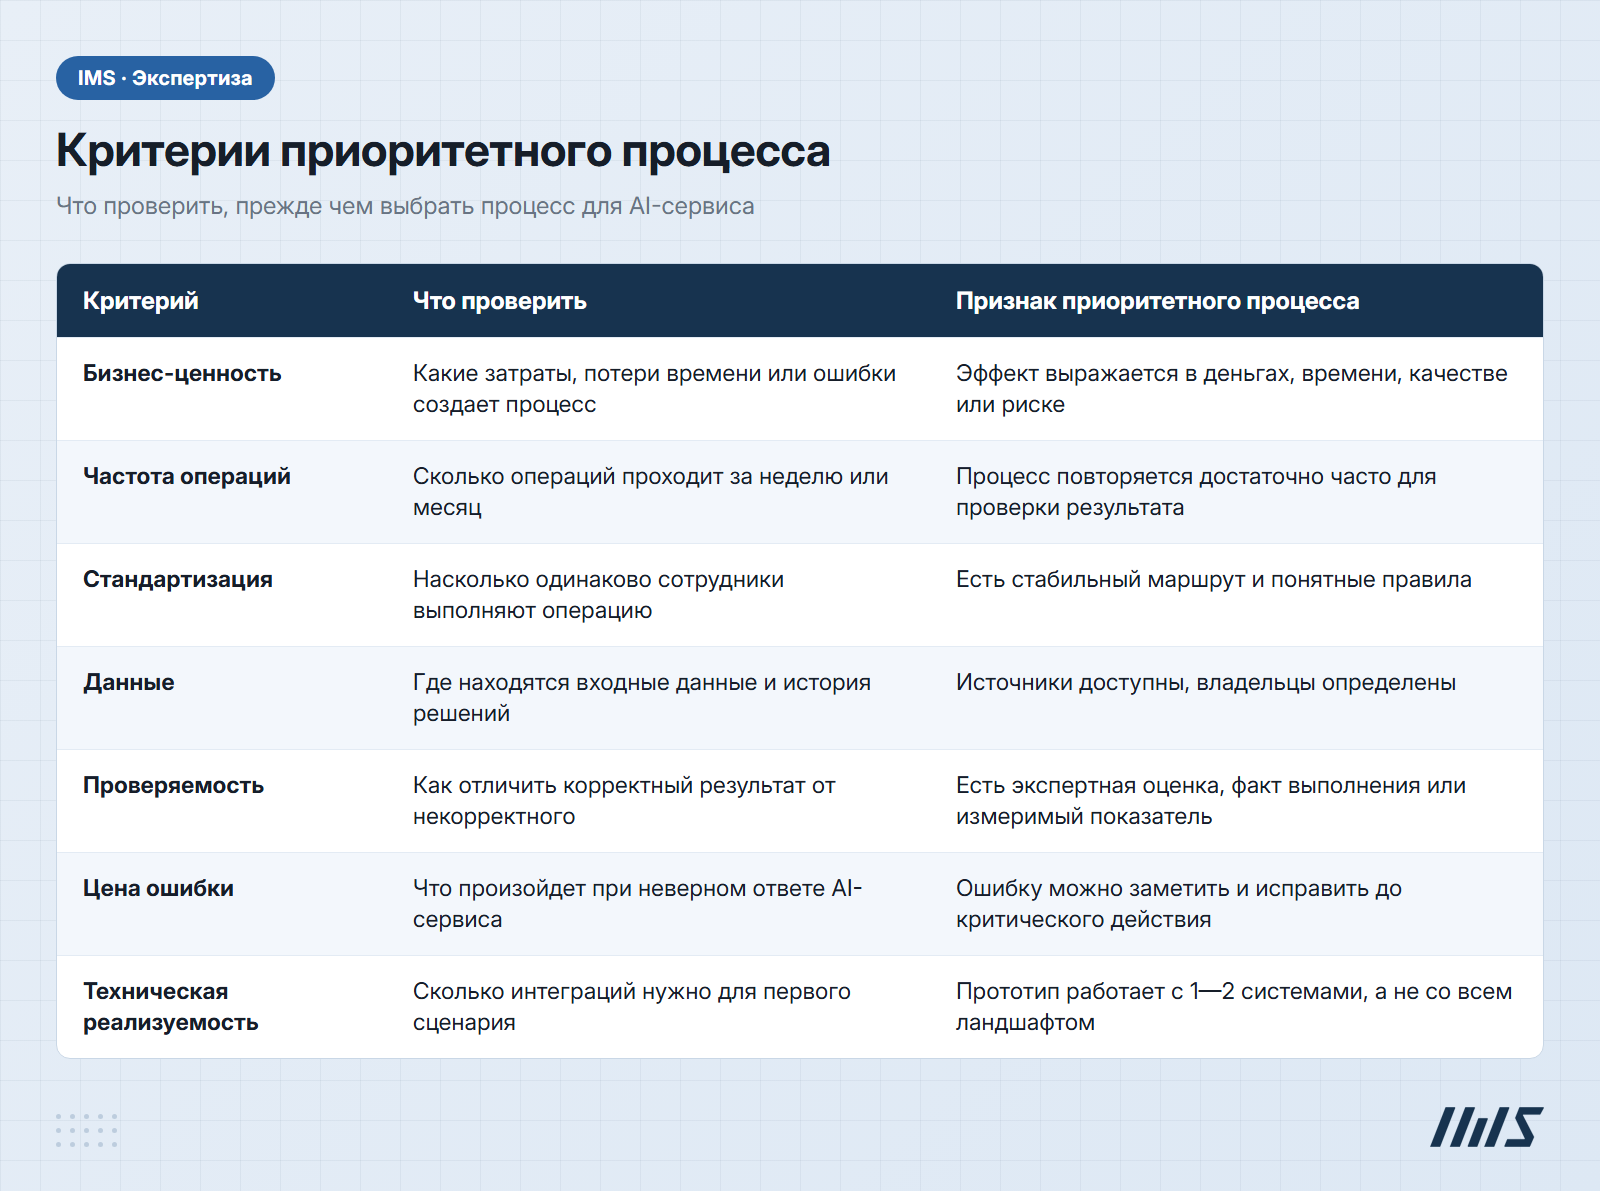
Приоритетный процесс — это процесс, в котором ожидаемый эффект AI-сервиса можно измерить, а результат проверить на реальных операциях. Такой процесс повторяется, имеет владельца, понятные входы и выходы, а ошибка не приводит к неконтролируемым финансовым, юридическим или репутационным последствиям.
Первый AI-сервис не должен охватывать всю компанию. Его задача проще: доказать, что конкретная операция выполняется быстрее, точнее или с меньшими затратами. Например, первичная классификация обращений в службе поддержки банка, поиск по регламентам в госкорпорации, извлечение реквизитов из документов в строительной компании или прогноз спроса на складе в логистике.
Таблица критериев выбора приоритетного процесса
Приоритет процесса определяет уровень измеримого эффекта. От доступности данных зависит, получится ли обучить, настроить и проверить AI-сервис. Чем выше цена ошибки, тем больше нужен человеческий контроль при запуске.
Практическая шкала: оценить каждый критерий от 1 до 5 и сложить баллы. Но важно учесть стоп-факторы. Например, процесс с высокой ценностью и отсутствующими данными не может стать приоритетным.
Какие процессы не подходят для первого AI-сервиса
- Процесс без владельца отпадает сразу: некому утверждать правила, принимать результат и менять рабочий порядок.
- Процесс с низкой частотой обращений тормозит проверку: на нем трудно быстро накопить статистику и подтвердить эффект.
- Процесс с неописанным маршрутом опасен для первого запуска: без понятного маршрута AI-сервис только автоматизирует хаос.
- Сценарий с более чем тремя интеграциями лучше отложить: их настройка увеличивает срок проверки гипотезы.
- Процесс, где AI-сервис самостоятельно принимает финансовое, юридическое или кадровое решение, для первого запуска не годится.
Принято считать, что начинать нужно с самого болезненного процесса. Но это работает только, если его можно разложить на операцию, данные и измеримый показатель.
Как оценить бизнес-ценность процесса и задать KPI
Бизнес-задача — это измеримая трансформация результата процесса, которая требуется компании. Она отвечает не на вопрос «что построить», а на вопрос «что должно измениться после запуска AI-сервиса». KPI — ключевые показатели эффективности, по которым это изменение проверяется до и после запуска.
Хорошая формулировка связывает процесс, проблему, целевой эффект и срок. Например: сократить время первичной обработки входящих заявок без роста доли ошибочной маршрутизации. Формулировка «внедрить AI-сервис для заявок» — это описание средства, а не бизнес-задача.
Связь бизнес-задачи и KPI
Для каждой отрасли один тип задачи будет рассматриваться по разному: в банке это скоринг заявок и обработка обращений, на производстве — контроль качества и прогноз спроса на сырье, в медицине — маршрутизация обращений и проверка полноты документации.
При запуске достаточно 3—5 KPI: один бизнесовый, один показатель качества результата, один показатель скорости и один показатель риска или затрат. Больше метрик часто создает только видимость контроля.
Как оценить операционный эффект
- Зафиксировать исходные показатели: время, стоимость, качество и объем операций до запуска.
- Определить единицу эффекта: минута на заявку, процент точности прогноза.
- Рассчитать потенциальный охват: какую долю операций реально обработает AI-сервис.
- Вычесть затраты на инфраструктуру, интеграцию, контроль качества и поддержку.
- Утвердить порог успеха прототипа до начала разработки.
Нюанс: сокращение времени не всегда дает экономию фонда оплаты труда. Если штатную нагрузку не сокращают, сотрудники получают больше задач. Это тоже эффект.
Как проверить готовность данных для AI-сервиса
Готовность данных определяется не объемом файлов и таблиц, а их пригодностью для конкретной бизнес-задачи. Данных достаточно, когда они покрывают ключевые сценарии процесса, доступны законно и технически, а их качество позволяет проверить результат внедрения AI-сервиса.
Что проверить до разработки
- Определены источники данных: ERP, CRM, ECM, служба поддержки, хранилище документов или другие корпоративные системы.
- Назначены владельцы данных, которые подтверждают состав, актуальность и правила использования.
- Понятны права доступа, наличие персональных данных, коммерческой тайны и иных ограничений.
- История операций должна содержать не только входные данные, но и то, чем каждая операция закончилась: верным результатом, ошибкой или исправлением. Без этого нет эталона, с которым можно сравнить ответы AI-сервиса.
- Данные можно регулярно обновлять после запуска AI-сервиса.
- Для проверки выделена выборка, которую эксперты готовы разметить или оценить.
Таблица проверки качества данных
Точность входного контекста и корректность проверки определяют качество AI-сервиса. Для RAG особенно важны актуальность, происхождение и структура документов. Без корректных метаданных поиск может найти нужный фрагмент, но не поймет, что регламент в нем уже отменен, и выдаст устаревшую версию как действующую.
Начинать без полного набора данных можно. Но только с ограниченным сценарием, честной выборкой и понятным способом собрать недостающие данные. При этом нельзя начинать без данных, на которых проверяется результат.
Как выбрать подход для реализации AI-сервиса
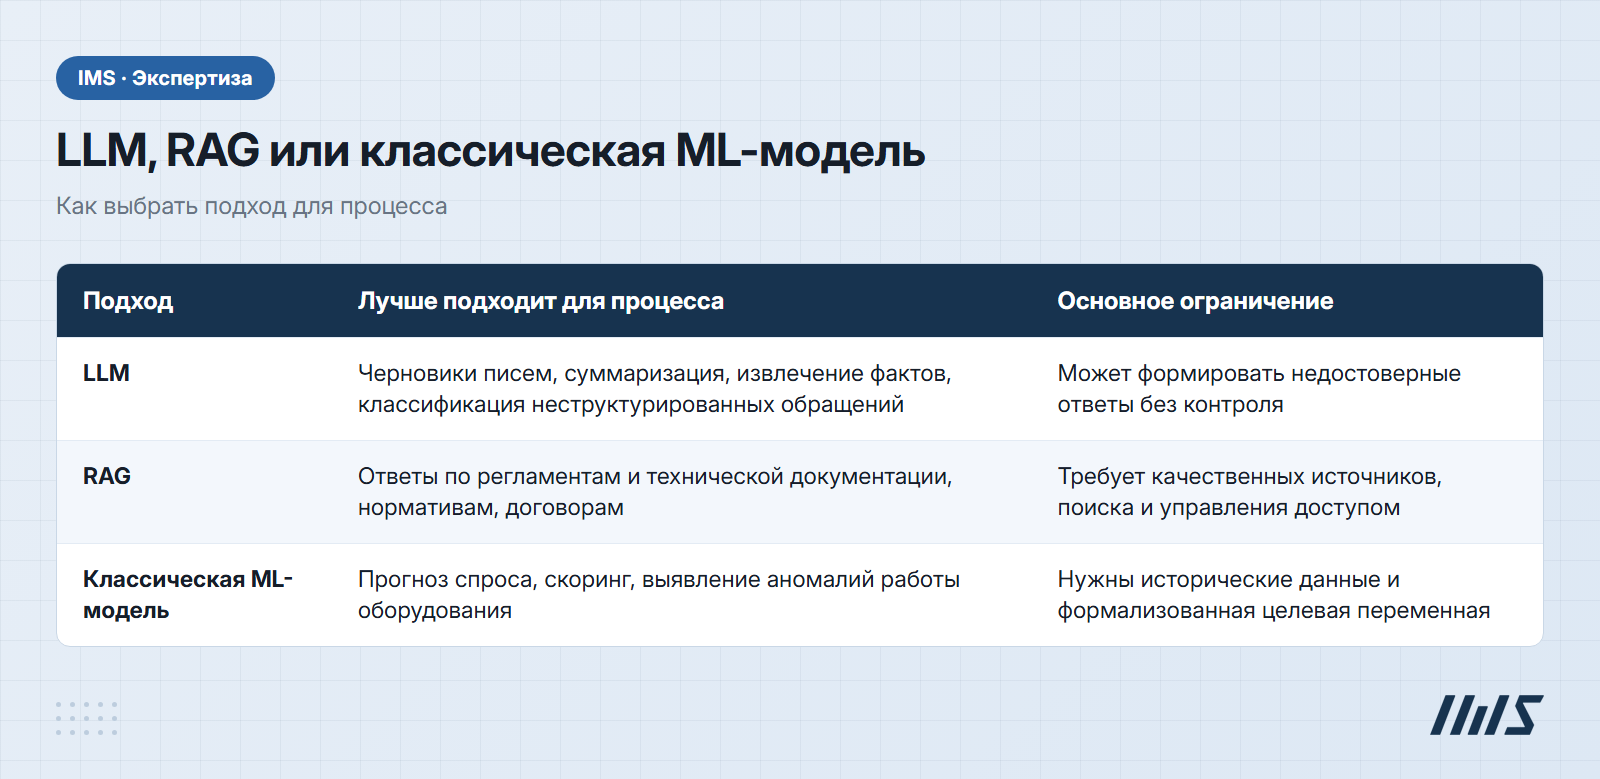
LLM — большая языковая модель, предназначенная для понимания и генерации естественного языка. RAG (Retrieval-Augmented Generation) — генерация с дополненным поиском: архитектурный подход, при котором LLM получает и обрабатывает найденные фрагменты из корпоративных источников перед формированием ответа. Классическая ML-модель решает задачу прогнозирования, классификации или ранжирования по структурированным признакам.
LLM работает с текстом и вариативными формулировками, RAG — немного иначе: он добавляет к LLM проверяемый корпоративный контекст. Классическая ML-модель не генерирует свободный текст, зато предсказывает число, класс или вероятность в формализованной задаче.
LLM обрабатывает неструктурированный текст и поэтому ускоряет корпоративный процесс. Риск неподтвержденного ответа снижает RAG, потому что подтягивает к ответу релевантные документы. Точность прогнозной операции повышает классическая ML-модель: она обучается на истории фактических исходов.
Для LLM есть два базовых способа настройки под задачу: промптинг готовой модели через инструкции и примеры, и дообучение (fine-tuning) на собственных данных компании. Промптинг быстрее запустить и дешевле поддерживать. Дообучение оправдано, когда задача узкая, стабильная и нужна высокая точность на большом потоке похожих запросов.
Процесс RAG (Retrieval-Augmented Generation) состоит из нескольких шагов: сначала документы разбивают на фрагменты (чанкинг), затем превращают их в векторы (эмбеддинги). Поиск релевантных фрагментов идет одновременно по ключевым словам и семантике (гибридный поиск). В конце результаты сортируют по релевантности (переранжирование) и только после этого передают в LLM для генерации ответа.
Для скоринга и прогноза спроса чаще всего применяют градиентный бустинг, так как он точнее всего работает с классическими табличными данными. В задачах бинарной классификации, где критически важна абсолютная объяснимость каждого шага для бизнеса или регулятора, используют логистическую регрессию.
В российской корпоративной среде уже есть прикладные примеры. В документации 1С заявлен штатный сервис «Прогнозирование продаж» для предиктивной аналитики в 1С:ERP. «Галактика Сверхновая» — новая AI-платформа. При выборе платформы значение имеет не название продукта, а конкретная функция, архитектура, интеграционный маршрут и ограничения данных. Прежде чем закладывать платформу в проект, лучше запросить у вендора техническое описание нужной функции.
Где компании ошибаются
Частая ошибка — выбирать LLM для любой задачи. Расчет скидки в ритейле, прогноз отгрузки на складе или скоринг контрагента в банке обычно не нуждаются в свободной генерации текста. Там нужна классическая ML-модель, правила или обычная автоматизация.
Поиск ответа по пятистам регламентам без RAG — плохая идея. LLM может звучать убедительно, даже когда отвечает неточно или ошибочно.
Как проверить гипотезу на прототипе
Прототип — это ограниченная проверка AI-сервиса на одном сценарии, данных выбранного периода и небольшой группе пользователей. Прототип не равен пилоту: пилот проверяет работу в реальной рабочей среде, а промышленное внедрение включает устойчивую эксплуатацию, безопасность, поддержку и масштабирование.
Для первого прототипа нужен один сценарий, одна роль пользователя, одна точка входа и один способ оценить результат. Практичный ориентир: 5—10 пользователей и 2—4 недели. Объем намеренно ограничивают, чтобы отделить ценность AI-сервиса от сложности большой интеграционной программы.
Мини-алгоритм прототипирования
- Выбрать один процессный сценарий с максимальной частотой или заметной стоимостью ручной операции.
- Зафиксировать входные данные, ожидаемый результат и допустимую ошибку.
- Собрать ограниченную, но репрезентативную выборку: типовые и пограничные случаи.
- Настроить AI-сервис без подключения всех корпоративных систем.
- Проверить результаты экспертами и сравнить с исходными показателями.
- Зафиксировать причины ошибок: данные, логика процесса, поиск, интерфейс или выбранный подход.
- Принять решение: доработать, расширить пилот или остановить работу.
Если прототипу сразу добавляют роли, согласования, SSO, отчетность и несколько интеграций, вместо прототипа получается долгий проект. Прототип же существует, чтобы проверить гипотезу как можно быстрее.
Как принять решение о масштабировании AI-сервиса
Масштабировать AI-сервис, то есть перейти от прототипа к пилоту и дальше к промышленному внедрению, можно, когда прототип подтверждает бизнес-эффект по заранее согласованным KPI, качество результата стабильно на новых данных, а процесс эксплуатации определен. Один удачный показ не считается подтверждением. Нужна повторяемость.
Мониторинг — это постоянный контроль работы AI-сервиса, качества результата, данных, затрат и рисков после запуска. Дрейф данных — изменение характеристик входных данных по сравнению с периодом, на котором сервис проверяли или настраивали.
Решение о масштабировании принимается при выполнении трех условий: KPI достигнуты или обоснованно близки к порогу, критические ошибки контролируются, а владельцы процесса готовы менять рабочий порядок. Если AI-сервис технически работает, но пользователи обходят его стороной, масштабировать нечего.
Российский контекст выбора процесса для AI-сервиса
Выбор приоритетного процесса в России в том числе зависит от среды хранения и обработки данных, импортозамещения, интеграций с действующими корпоративными системами и требований информационной безопасности. По данным Strategy Partners, рынок генеративного ИИ в России вырос примерно в 4,5 раза — и это скорее развело стратегии компаний в разные стороны, чем просто добавило готовых продуктов на полку.
Крупный бизнес и организации, подпадающие под требования к критической информационной инфраструктуре, выбирают между двумя путями: облачными проприетарными моделями от лидеров рынка, такими как YandexGPT и GigaChat, и собственными изолированными решениями на основе открытых моделей вроде Llama, Mistral или Qwen, дообученных на внутренних данных компании. Рост рынка не облегчает проверку архитектуры, а усложняет ее: важна не только производительность модели, но и права на обучающие данные, а также возможность развернуть всю инфраструктуру на собственных мощностях, без выхода во внешнее облако.
Перед запуском AI-сервиса внутри российской компании нужно проверить:
- возможность развернуть сервис в допустимой среде: на собственной инфраструктуре, в частном облаке или в ином согласованном варианте;
- правила работы с персональными данными, коммерческой тайной и отраслевыми ограничениями;
- совместимость с 1С:ERP, системами управления корпоративным контентом (ECM), CRM, службой поддержки и корпоративной системой управления доступом;
- наличие русскоязычных документов, справочников и терминологии для поиска и оценки качества;
- возможность заменить внешний компонент без остановки критичного процесса;
- условия поддержки, обновления и журналирования действий AI-сервиса.
Вопрос не только в том, где находится LLM. Вопрос в том, кто видит исходный документ, как фиксируется ответ и можно ли объяснить маршрут данных. Именно здесь решается судьба промышленного внедрения.
FAQ
Что делает процесс приоритетным для разработки AI-сервиса?
Единого признака нет. Процесс становится приоритетным только при сочетании факторов: без владельца или без данных даже самый выгодный процесс не пройдет отбор.
Какие KPI использовать для оценки AI-сервиса на старте?
Обычно достаточно 3—5 показателей: десятки метрик из разных отчетов лишние. Они создают видимость контроля, но не помогают понять, работает сервис или нет.
Как проверить, достаточно ли корпоративных данных для AI-сервиса?
Формальный объем данных ничего не говорит о готовности. Решает, покрывают ли данные типовые и пограничные сценарии процесса и есть ли эксперт, готовый подтвердить корректный результат.
Когда для процесса подходит LLM?
LLM подходит, когда процесс построен вокруг текста, а формулировки могут отличаться от раза к разу. Для процессов с одним правильным ответом и жесткими расчетами лучше классическая ML-модель или обычная автоматизация.
Чем отличается применение LLM, RAG и классической ML-модели?
Для свободного ответа на языке пользователя берут LLM. Если ответ должен опираться на конкретные корпоративные документы, добавляют RAG. Для точного прогноза или классификации по признакам используют классическую ML-модель.
Можно ли начинать разработку AI-сервиса без полного набора данных?
Можно, если прототип ограничен одним сценарием и использует достаточную для проверки выборку. Для промышленного внедрения нужны данные для контроля качества и мониторинга.
Какой объем процесса выбирать для первого прототипа AI-сервиса?
Чем шире объем, тем сложнее отличить пользу AI-сервиса от сложности самой интеграции. Для первого прототипа берут один сценарий и небольшую группу пользователей на срок в несколько недель.
Когда результаты прототипа позволяют масштабировать AI-сервис?
Масштабирование возможно, когда KPI подтверждены на репрезентативной выборке, качество стабильно, критические ошибки контролируются и определен мониторинг.
Какие метрики мониторинга нужны после запуска AI-сервиса?
После запуска стоит закрыть сразу несколько срезов: техническую доступность сервиса, качество ответов, влияние на бизнес-показатели и риски.
Какие процессы не стоит выбирать для первого AI-сервиса?
Не стоит выбирать процесс, если результат некому оценить, статистики по нему мало или AI-сервис должен сразу принимать решение без участия человека.